人工知能をめぐる喧騒は、いまや世界のテクノロジー業界のほぼ全域を覆っている。デモ動画が数時間で拡散し、資金調達の金額がそのまま技術力の証明であるかのように語られ、モデルのパラメータ数が競争の物差しとして扱われる。だが、その熱気のすぐ内側には、冷ややかな運用上の事実が横たわっている。アルゴリズムの性能そのものは、企業価値を自動的に生み出しはしない、という事実だ。
現場で実際に数字を作っている経営者や技術責任者は、たいてい別のものを見ている。モデルの新規性ではなく、業務の流れのどこに人間の判断が滞留しているか。データが機能サイロのあいだでどれだけ分断されているか。そして、予測という入力のコストが下がったとき、自社のユニットエコノミクスがどう書き換わるか。この視点の差が、次のテクノロジーサイクルで勝者と敗者を分ける。
ここでは、AIを製品の飾りではなく業務を実行するランタイムとして据え直すための設計論を、経済学・組織論・具体的な企業事例の三方向から掘り下げていく。
ハイプと価値創出のあいだに横たわる断絶
現在のAIブームの中心にある誤解は、アルゴリズムの能力と経済的価値が同じ方向に比例して伸びるという前提だ。公開されたベンチマークで高いスコアを出すモデルが、そのまま企業の粗利を押し上げるわけではない。両者のあいだには、データの流れ、権限設計、承認フロー、そして責任の所在という、地味だが決定的な構造物が挟まっている。
この断絶が生まれる典型的な理由は、AIが業務プロセスに組み込まれず、既存の業務の外側に新製品として接木されることにある。チャット画面が追加され、レポートに要約ボタンが付き、問い合わせ対応の下書きが生成される。どれも便利ではあるが、実行の主流路は依然として人間の手作業のままだ。予測が意思決定の現場に入り込んでいない以上、コスト構造は一円も変わらない。
企業変革が本当に起きるのは、予測アルゴリズムが実験の余白から降りてきて、価格設定・与信・在庫配分・ルーティングといった中核プロセスの実行を直接担う瞬間である。そこに至ってはじめて、デジタル化された業務データは複製・伝送・実行の限界費用がほぼゼロになり、相互接続されたソフトウェアサービスを通じて動的に連携し、テレメトリのフィードバックループで継続的に最適化される。
- 表層機能の追求:分断されたレガシーデータベースの上に、薄いアルゴリズムのインターフェースを貼るだけで、実行経路を変えない。
- ボトルネックの除去:業務のクリティカルパスを再設計し、リアルタイム実行から人間の意思決定労働を外していく。
- 汎用知能への期待:汎用AIが未整理のドメイン課題を自律的に解く日を待ってしまう。
- 弱いAIの産業化:教師あり学習や統計的予測を、高頻度・定型的な業務判断の自動化に産業的な規模で投入する。
- パラメータ数への執着:モデル規模や生成の新規性で能力を測る。
- アーキテクチャへの注目:データパイプラインの健全性、継続的実験のループ、APIのモジュール性で評価する。
マーケットを定義する変革に必要なのは強いAIではない。人間の認知や汎用的推論を模倣するシステムではなく、離散的で高頻度な業務判断を安定的に代替する弱いAIで十分だ。この割り切りができるかどうかが、投資対効果の読み方を根本から変える。
AIファーストという言葉の誤用が招く三つの失敗
経営トップがコンピューティングパラダイムの転換を語るとき、しばしば引用されるのが、AIはすべての業務を形づくるランタイムになるというサティア・ナデラの表現であり、AIファーストというスンダー・ピチャイの方向づけだ。しかし、このビジョンをAIを機能として追加することだと読み違えた企業は、スタートアップも既存大手も等しく同じ罠にはまる。
本物のAI戦略には、相応の構造的再設計が伴う。マイクロソフトが実行のランタイムをクラウドとAIへ移したとき、年間50億〜60億ドル規模のクラウド設備投資を継続的に投じ、AzureをLinuxやオープンソースのエコシステムに対応させるために再設計し、スコット・ガスリー(クラウド&AI)やカート・デルベネ(コアサービスエンジニアリング&オペレーション)の下で組織を組み替えた。この水準のコミットメントがないままでは、次の三つの構造的失敗に落ちる。
- レガシー重ね着の罠:標準化されていないサイロ化データベースの上に機械学習モデルを重ねる。機能ごとに孤立したデータベースでは、継続的なシステム学習に必要な全社的な業務データを集約できない。
- 人間実行のボトルネック:高頻度の業務経路に手作業の承認ステップを残す。管理の複雑性コストを温存し、事業のスケールに硬い上限を課すことになる。
- 静的アーキテクチャの欠落:標準化されたAPIを持たないモノリシックなコードベースを維持し、クラウド生態系やサードパーティ開発者との接続を塞いでしまう。
三つに共通するのは、技術の問題ではなく組織の設計問題だという点である。AIの導入が停滞する理由をモデルの精度不足に求める限り、同じ失敗が形を変えて繰り返される。
予測コストの急落という経済学の土台
B2Bの事業を長く成立させたいなら、AIを経済学のレンズで評価する必要がある。アジェイ・アグラワル、ジョシュア・ガンズ、アヴィ・ゴールドファーブが『Power and Prediction』で示したのは、人工知能の本質的な経済効果が予測のコストの劇的な低下だという整理である。
予測とは、生の活動データを不確実性下の行動可能な意思決定へ変換する、中心的かつ基礎的な業務入力だ。基礎的な入力のコストが急落すれば、その用途は企業の隅々へ拡大する。人間の経験則に依存した経営判断は、自動化された産業的な意思決定エンジンに置き換わっていく。
伝統的な不確実性下の意思決定は、遅く直感的な人間のヒューリスティクスに依存しており、業務のばらつきと管理のオーバーヘッドを必然的に伴う。統計的予測を産業化することは、意思決定を手作業の勘所から、安価でスケールするソフトウェア入力へと変質させる。これは業務改善の話ではなく、企業のランタイムそのものの交換である。
ここで見落とされがちな副作用がある。予測が安くなると、これまで判断しなくてよいとされてきた領域まで判断の対象になる。在庫の一品単位、顧客の一人単位、配送の一区間単位。意思決定の粒度が細かくなるほど、人間の承認を挟む設計は物理的に破綻する。だからこそ、予測コストの低下は自動的に、人間を経路から外す設計を要求する。
ビジネスモデルとオペレーティングモデルの同時設計
マルコ・イアンシティとカリム・ラクハニが『Competing in the Age of AI』で示したのは、持続的な企業パフォーマンスがビジネスモデルとオペレーティングモデルの整合に依存するという原則だ。AIを原生に組み込んだ企業は、この方程式の両辺を同時に書き換えることで、模倣困難な競争優位を手にする。
ビジネスモデルは価値創出と価値捕捉に分かれる。価値創出とは顧客に対して何を約束するかであり、価値捕捉とはその約束をどう収益に変えるかである。従来型企業は静的な製品機能で価値を作り、単価あたりの利益率で価値を捕まえる。AI原生の企業は、価値創出の側で動的な応答性、極端なパーソナライゼーション、常時稼働の可用性を提供し、価値捕捉の側では利用量・ネットワーク量・生態系内取引に基づくマルチサイドの収益構造を組む。
マルチサイド化したプラットフォームでは、価値捕捉は次の式で指数的にスケールする。価値捕捉=N×E×M。Nは各サイドにまたがるネットワーク参加者の数、Eは生態系の接点を横断するユーザーエンゲージメントの深さ、Mは接続されたプラットフォームサービス単位あたりの収益化率だ。線形の物差し(価格マイナスコスト)で管理している限り、この指数は見えない。
オペレーティングモデルの側にはスケール、スコープ、ラーニングという三本の柱がある。スケールは限界費用ほぼゼロで大規模な利用者層に届けること。スコープはモジュール化されたデジタルアーキテクチャを通じて補完的な事業を連結し、提供範囲を広げること。ラーニングは統計アルゴリズムと体系的な実験によって業務改善を自動化し、取引のたびに組織が賢くなる状態を指す。
従来型のオペレーティングモデルは、規模が拡大するほど人間の調整コスト、管理職のコミュニケーション摩擦、事務処理の滞留が積み上がり、コスト構造が上向きに湾曲して成長に上限がかかる。AI原生のデジタルオペレーティングモデルは、実行経路から人間のボトルネックを外すことで、利用者数とデータ量の拡大とともに業務性能が向上し、限界運用コストがゼロに近づいていく。同じ成長という言葉が、まったく別の曲線を指している。
コンウェイの法則とアーキテクチャ慣性という壁
AI原生のオペレーティングモデルを築くには、深い組織的摩擦と向き合わなければならない。コンウェイの法則、および関連するミラーリング仮説が示すのは、組織の技術システムのアーキテクチャが、それを設計したチームのコミュニケーション構造を鏡のように反映するという性質だ。
クレイトン・クリステンセンが『イノベーターのジレンマ』で論じ、レベッカ・ヘンダーソンとキム・クラークがアーキテクチャ・イノベーションの研究で明らかにしたのは、既存組織が機能サイロに沿った業務ルーチンを深く定着させるという事実である。結果として生まれるのがアーキテクチャ慣性だ。個々の技術要素が進歩しても、システム間の結合関係を組み替えられない構造的な不全である。
既存の大手が失敗するのは、AIを孤立した部品の革新としてレガシーな機能サイロに挿入しようとするからだ。たとえばマーケティング部門の中に分析ツールを一台置く、といった形である。勝つ創業者はここが違う。AIが要求するのはアーキテクチャの革新、すなわちデータの取り込み、予測アルゴリズム、自動実行の経路を企業横断でつなぐ基礎的な結合関係の再設計だと理解している。
実務的には、この壁は三つの兆候として現れる。新しいモデルを入れても既存KPIが動かない。データの整備に毎回同じ手作業が発生する。そして、あるチームの改善が別チームの手戻りを生む。いずれもモデルの問題ではなく、結合関係の問題だ。
AIファクトリーという中核エンジンの四層構造
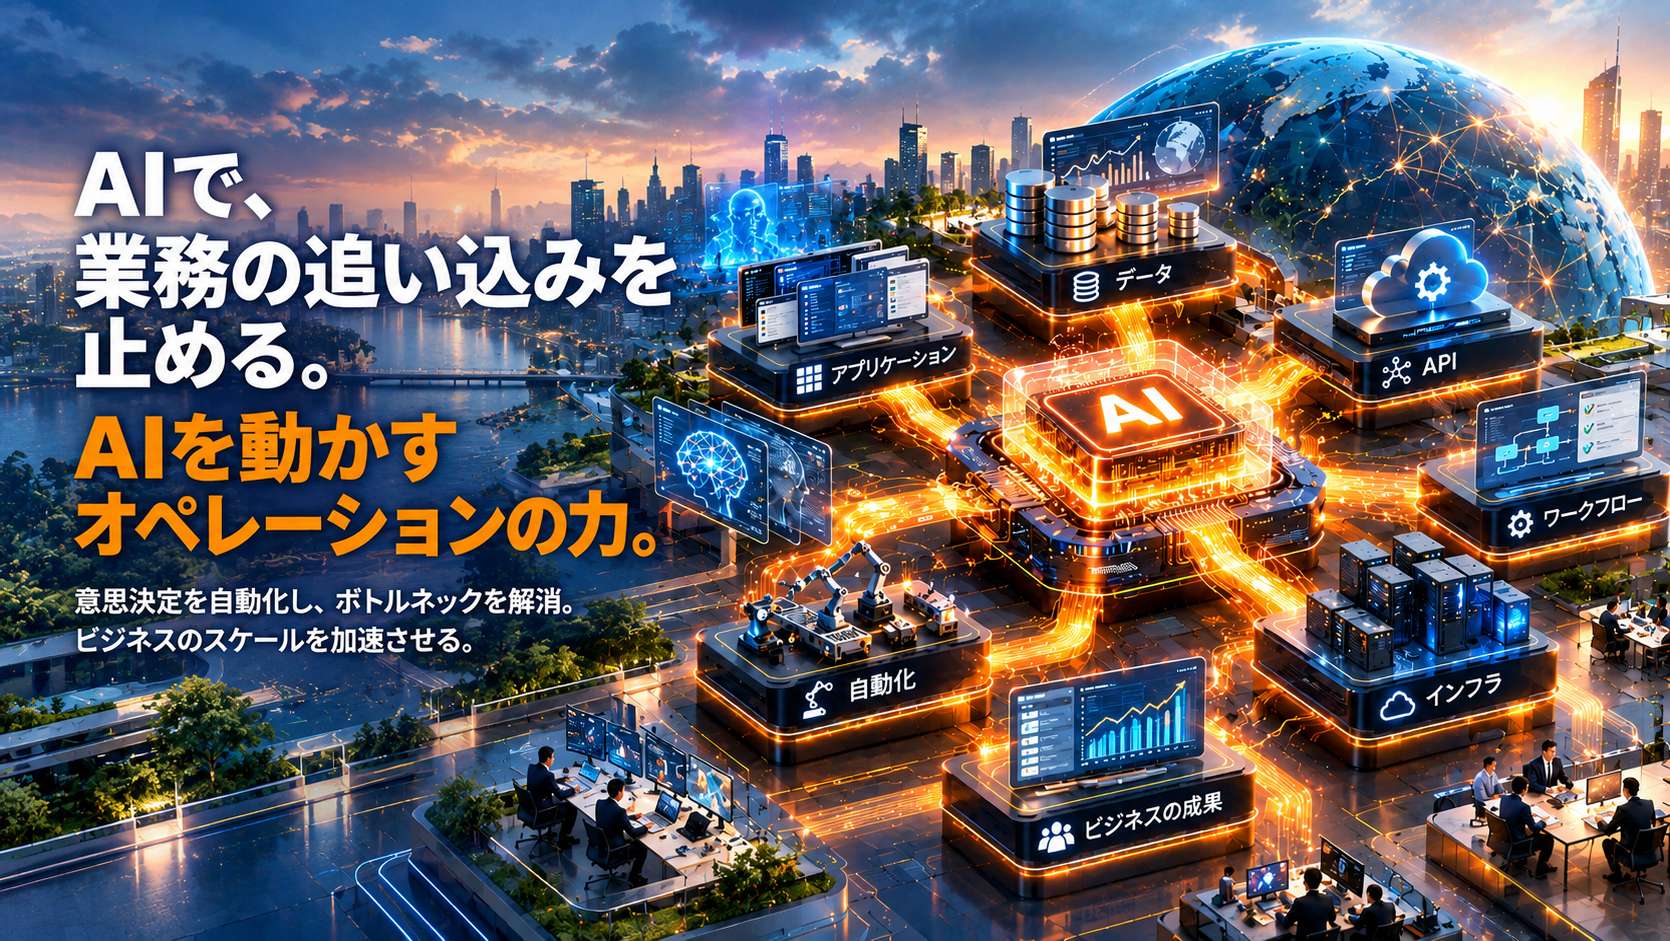
現代のデジタル企業の心臓部にあるのはAIファクトリーと呼ばれる意思決定エンジンだ。データ収集、モデル学習、予測生成、ソフトウェア配備を産業的に回す仕組みであり、四つの層で構成される。第一層はデータパイプライン(収集・洗浄・正規化・統合・保護)。第二層はアルゴリズムのアーキテクチャ(教師あり、教師なし、強化学習とマルチアームバンディット)。第三層は実験プラットフォーム(仮説の形式化とランダム化比較テスト)。第四層はモジュール化されたソフトウェア基盤とAPI(パブリッシュ・サブスクライブ型のデータ流通とマイクロサービス)である。
データパイプラインからすべてが始まる
データはAIファクトリーの燃料だ。予測モデルを動かすには、進行中の業務活動を構造化された機械可読なデータセットへ体系的に変換するデータ化を実行しなければならない。アリババのミン・ゼンが整理したこの概念は、単なるデジタル化とは異なる。業務の事実を、後から学習に使える形で残すという意味だ。
分かりやすい例がサーモスタットだ。Nestは家庭の空調というアナログな市場を、室温と在宅パターンのリアルタイム取得によってデータ化し、住宅の空調効率を自動で最適化した。ピットニー・ボウズは郵便機器の老舗メーカーから、住所という物理情報をナレッジ・ファブリックとしてデータ化するデジタルプラットフォームへ転身し、企業分析、位置情報インテリジェンス、不正検知を支える存在になった。
企業級のデータパイプラインには五つの工程がある。顧客接点、エッジデバイス、基幹データベースを横断して業務テレメトリを体系的に収集すること。センサーのノイズを除去し、取引の異常を突き合わせ、欠損を解消するクリーニング。測定単位や業務定義を組織のドメイン間で標準化する正規化。分断されたデータストリームをデータレイクやパブリッシュ・サブスクライブ型の基盤に統合すること。そして、IDアクセス制御、暗号化、企業統治のプロトコルによって利用者のプライバシーを守る保護である。
この五工程のうち、多くの企業が最初の二つで止まる。収集とクリーニングは予算化しやすいが、正規化と統合は部門間の合意が必要で、政治になる。しかし予測の質を決めるのは、実のところ後半の二工程だ。
三つの学習パラダイムを業務に割り当てる
AIファクトリーは、整備されたデータを三つの機械学習パラダイムによって予測的な判断へ変換する。教師あり学習は、入力Xを専門家がラベル付けした結果Yへ写像し、予測誤差を最小化する。用途は与信リスクの自動スコアリング、画像診断、スパム判定など、正解が定義できる領域だ。教師なし学習は、ラベルのないデータから構造的なパターン、自然なクラスタ、異常を発見する。顧客の嗜好クラスタリング、不正の異常検知、市場セグメンテーションが代表例となる。
強化学習とマルチアームバンディットは、探索(未知の選択肢を試す)と活用(既知の勝ち筋を最大化する)のバランスを取りながら、動的な方針決定を最適化する。動的価格設定、物流のルーティング、リアルタイムの推薦が該当する。ここでの設計上の焦点はリグレットの最小化だ。リグレットとは、探索段階で準最適な選択をしたことによって生じた累積の機会費用を、事後に最適だった選択と比較して測った値である。リグレットを数学的に抑え込むことで、短期的な粗利の獲得と長期的なシステム学習のバランスを、感覚ではなく設計として扱えるようになる。
実務でよくある誤りは、この割り当てを逆にすることだ。正解ラベルが曖昧な領域に教師あり学習を当てて精度が出ないと悩み、逆に正解が明確な領域にバンディットを持ち込んで学習コストを無駄に払う。パラダイムの選択は、データの問題ではなく業務の構造の問題として決めるべきだ。
実験基盤——相関から因果へ渡る橋
統計的予測は経験的な相関を見つけるが、業務の実行には因果の証明が要る。相関のまま価格を動かせば、季節要因と値下げの効果を取り違えて粗利を削る。だからこそ高性能なAIファクトリーは、予測モデルを継続的なランダム化比較テストにさらす実験基盤を内部に持つ。
この構造の説得力ある実例が、ハーバード大学のLISH(Laboratory for Innovation Science)による肺がん腫瘍マッピングの取り組みだ。CT画像上で肺がん腫瘍の三次元境界を特定する作業は、従来、放射線治療の専門医が一件あたり8分の手作業を要していた。LISHは標準化されたAIファクトリーの構造を採用し、Topcoderを通じたクラウドソーシング型のアルゴリズムコンペを実施。461症例、7万7,000枚のCTスライスを対象にした。結果として10週間のうちに、群衆由来の深層学習モデルが腫瘍境界を1件あたり15〜120秒で特定し、ハーバードで訓練された放射線腫瘍医と同等の精度に到達、既存の商用臨床ソフトウェアを上回った。
この事例の本質は、AIが専門医を置き換えたことではない。課題の定義、データの標準化、評価指標の固定、そして外部からの参加経路の設計という四つを整えたことで、短い期間に探索空間を広げられたことにある。実験基盤とは、こうした比較可能性のインフラだ。
APIマンデートとモジュール化という規律
AIファクトリーは、ソフトウェアが密結合のままではスケールしない。標準化されたAPIで接続されたマイクロサービス構造があってはじめて、プロダクト開発チームは独立して作り、試し、出せるようになる。
運用上のモジュール化の青写真として繰り返し参照されるのが、2002年にアマゾンで示されたAPIマンデートだ。すべてのチームはデータと機能をサービスインターフェース経由で公開すること。チーム間の通信はこのインターフェースのみを通すこと。直接リンク、他チームのデータストアの直接参照、共有メモリモデル、裏口は一切認めないこと。技術選択は自由だが、すべてのサービスインターフェースは例外なく外部公開可能な形で設計すること。そして、これに従わない者は去ってもらう、という明確なメッセージが添えられていた。
この規律がもたらしたのは、社内の業務アプリケーションを外部化可能なサービスへ作り替えたことだった。それがAWSと現代のクラウドコンピューティングの技術的土台になったのは周知のとおりだ。注目すべきは、これが技術施策ではなく組織施策として打ち出された点である。モジュール性は設計原則であると同時に、権限と責任の配分ルールでもある。
人間をクリティカルパスから外すという決断
勝つAI企業が実行する決定的な転換は、製品提供のリアルタイム実行経路から、手作業の人間労働を意図的に外すことだ。従来型の経路は、顧客の要求、人間による手動レビュー、人間の判断、提供という四段で回る。結果として、規模の制約、高い限界費用、指数的に膨らむ複雑性コストを抱え込む。
AI原生の経路は、顧客要求、自動化されたデータパイプライン、AI予測エンジン、即時実行という流れになり、そこに人間のシステム設計者がフィードバックと統制の側から接続する。人間の役割は、システム設計者として業務フローを設計し、イノベーターとして新しい用途を発明し、インテグレーターとしてAPIをつなぎ、ガーディアンとして統制を監視する立場へ移る。
この移行をためらう組織は多い。理由は往々にして倫理や雇用ではなく、責任の所在が曖昧になることへの恐れだ。だからこそ設計段階で、どの予測がどの範囲でどの実行を担うのか、例外時には誰が止めるのかを明文化しておく必要がある。
ゼロ限界費用の実行を実証した三つの事例
アント・ファイナンシャル(MYbank)は、中国の小規模融資を3-1-0モデルで塗り替えた。申請はモバイルで3分、アルゴリズムによる与信承認は1秒、人間の介在はゼロ。アリババのEC生態系におけるリアルタイムの行動データを評価し、1件の申請あたり3,000以上の与信リスク変数を同時に処理する。取引あたりの運用コストは約2元で、従来型銀行の約2,000元と比べて三桁の差がつく。300人規模の組織が500万社以上の小規模事業者に対応できるのは、この構造があってのことだ。
英国のオンライン食料品小売オカドは、傷みやすい生鮮品のためにAI駆動のロボティクス・フルフィルメント基盤を設計した。自動化倉庫はサッカー場11面分の広さに及び、35マイルの自動コンベヤと数千台の連携ピッキングボットを収容する。予測アルゴリズムは配送車両のルーティングをリアルタイムで計算し、農場から食卓までの供給制約を数日前に予測し、50品目の注文を数分で捌く。時間通りの配送率は98.5%に達する。
ペロトンは、アナログなフィットネス機器をソフトウェア駆動のコンテンツプラットフォームへ変えた。タッチスクリーン、パフォーマンスのテレメトリ、ネットワーク接続を据え置き型バイクに統合し、ライブ配信のフィットネス指導を載せた。ソウルサイクルのスタジオ指導者が1クラス30人の物理的な参加者を教えるのに対し、ペロトンの1人の指導者は世界中の同時接続2万人へ配信する。サブスクリプション収益は反復し、年間継続率は95%に達する。
三事例に共通するのは、AIが主役ではなく実行の下請けであるという構図だ。与信、ピッキング、指導という業務の型は変わっていない。変わったのは、その型を回す単位コストと速度である。
キャズムを越えるのはオペレーショナル・ユーティリティ
ジェフリー・ムーアの採用モデルに従えば、技術企業はキャズムで停滞する。新しい生成的デモに興奮するビジョナリー層にだけ売れ、実務を重視するプラグマティスト層に届かない状態だ。キャズムを越える創業者は、運用上の有用性、信頼性、摩擦のない実行でソフトウェアを評価するB2Bの購買担当者に照準を合わせる。
ハイプ主導のスタートアップは汎用的なモデル能力を売る。サイクルを制する企業は、業務の接点を自動化し、単位あたりの経済性を下げ、人間実行のボトルネックを除去するドメイン特化型のAIファクトリーを配備する。買い手の言葉に翻訳すれば、売り物は賢さではなく、今月の処理件数と一人あたりの工数だ。
コールドスタートを越えるデータフライホイール
持続可能な競争の堀を築くには、業務データを使って動的なネットワーク効果と自己強化のフィードバックループを作らねばならない。プラットフォーム拡大論で語られるコールドスタート問題、つまり初期データの不足をどう越えるかは、AI企業にとって死活問題である。
解はデータフライホイールの設計にある。対象となる業務フローから基準となる取引データを取得し、整備したドメインデータで特化型の予測アルゴリズムを学習させ、パーソナライズされた摩擦の少ない顧客体験として提供し、利用量と取引頻度を押し上げ、その結果として業務データが複利的に蓄積され、後発の参入障壁になる。このループは一度回り始めると加速するが、最初の一周は手作業で押し込むしかない。
スコープの拡張も同じ原理で進む。テンセントのWeChatは、PC向けメッセージングサービスからモバイルの生態系へ進化した。標準化されたAPIをサードパーティ開発者に開放し、モバイル決済、公共料金の支払い、医療の予約、小売の商取引を一つのアプリ画面に統合した。顧客獲得コストを大きく下げつつ、ライフタイムバリューを引き上げる構造だ。アマゾンのAlexaは、スマートマイクというハードウェアを生態系のハブへ変えた。スキル開発プラットフォームを開放し、数万規模の音声アプリを小売とメディアの生態系に接続している。
B2B統合の実務——四つの評価軸
企業向けの技術事業にとって、真のプロダクト・マーケット・フィットは既存の技術スタックへの摩擦のない統合にかかっている。Sald.ioのようなB2Bの実行支援プラットフォームがこの設計思想に沿うのは、手作業の接点をデジタル化し、分断されたデータストリームを統合し、管理のオーバーヘッドを増やさずに業務判断を自動化することを狙っているからだ。情報アーキテクトが企業向けプラットフォームの統合を評価する際の軸は、おおむね次の四つに集約される。
- APIのモジュール性:CRM、ERP、データレイクといった既存の業務システムへ、大規模な書き換えなしに接続できるか。
- リアルタイムのテレメトリ:業務上のインタラクションデータを即時に抽出し、中央の予測モデルを継続的に更新できるか。
- 業務フローの自動編成:アルゴリズムの出力を、従業員と顧客が日常的に使うソフトウェアの画面の中で直接実行できるか。
- 企業統制:権限管理、データ分離、コンプライアンス監査の機能が備わっているか。
この四軸は、導入後の定着率を予測する指標としても機能する。最初の二つが欠けていると運用が手作業に戻り、後の二つが欠けていると情報システム部門の審査で止まる。
自社の立ち位置を測る四つの診断軸
経営陣がクラウドとAIへの移行を評価するには、感覚ではなく診断の型が要る。次の四次元で構成する自己診断は、そのたたき台として使える。採点は各軸0〜3点とし、0〜1点をレガシーまたはハイプの罠、2〜3点をAI原生または次サイクル対応と位置づける。
- データ基盤:データが機能サイロに孤立し非標準の形式で保存されている(0〜1点)か、クリーニングと正規化が自動化された統合型のデータ基盤と社内APIレジストリがある(2〜3点)か。
- アルゴリズム統合:機械学習モデルが孤立した実験や、担当者が目で見る外部ダッシュボードに留まっている(0〜1点)か、予測アルゴリズムが価格、ルーティング、承認といった実行経路を直接担っている(2〜3点)か。
- クリティカルパスの自動化:日常の業務判断や取引フローに人間のレビューが必須(0〜1点)か、人間がリアルタイム実行から外れ、設計者、革新者、統治者に徹している(2〜3点)か。
- アーキテクチャの柔軟性:密結合のモノリシックなコードベースで機能サイロが温存されている(0〜1点)か、モジュール化されたマイクロサービスと俊敏な機能チーム、外部化可能なAPI標準がある(2〜3点)か。
合計点そのものより、軸ごとのばらつきを見るべきだ。データ基盤が3点でクリティカルパスが0点なら、その組織は分析はできるが実行ができない。逆に実行だけが進んでいる組織は、統制の穴という別のリスクを抱えている。
スケールの代償としての統治と倫理
無制限のスケール、スコープ、学習能力を持つAI駆動のオペレーティングモデルは、独特のシステムリスクを持ち込む。経営陣は次の三つを交渉不能の原則として運用に埋め込む必要がある。
第一に、アルゴリズムの偏りとデータ整合性の継続監査。学習データセットを定期的に検証し、予測モデルが過去の人間の偏見や統計的な歪みを再生産していないかを確認する。第二に、サイバーセキュリティとプライバシーの構造的な設計。中央集権的なデータ統治、ゼロトラストのネットワークアクセス、APIのスロットリングによって、企業のデータ資産を不正な抽出や侵害から守る。第三に、プラットフォームの監督とシステム境界の明確化。自動化された意思決定の結果を監視するガードレールを設け、信頼性、規制遵守、組織の説明責任を担保する。
これらは導入の後工程ではなく、アーキテクチャの一部として先に決めるべきものだ。後から足す統制は、たいてい実行経路を人間に戻す形で実装され、せっかくの限界費用の優位を消してしまう。
次サイクルのリーダーに求められる構え
コンピューティングプラットフォームの歴史は、市場の主導権が構造転換を要求することを繰り返し示してきた。マイクロソフトの歩みは明快な参照モデルである。確信と忍耐のバランスを保ちながら、年間50億〜60億ドルのクラウド基盤投資を振り向け、AzureをオープンソースのLinuxを中心に再設計し、スコット・ガスリー(クラウド&AI)とカート・デルベネ(コアサービスエンジニアリング&オペレーション)の下で組織を再編した。この関与によって中核のランタイムはデスクトップOSからAI駆動のクラウド基盤へ移り、時価総額は3倍になった。
次のテクノロジーサイクルを制する創業者は、表層的なモデルのラッパーや生成の目新しさで短期的な注目を集める人々ではない。ノイズの外側を見て、予測が安くなるという経済学を受け入れ、アルゴリズムで自動化され、高度にスケールし、構造的に耐久性のあるオペレーティングモデルを築く規律ある設計者だ。
問いはシンプルである。自社の業務のうち、いま人間の判断が滞留している箇所はどこか。その判断は、十分なデータがあれば統計的予測に置き換えられるのか。置き換えたとき、単価あたりのコストと処理速度はどう変わるのか。そして、その置き換えを妨げているのは技術ではなく、どの結合関係なのか。ハイプを追うのをやめ、ランタイムを組み始めた者が、静かに差を広げていく。